Agent记忆的文件格式
Memoryfields:大幅简化智能体记忆管理的方案
许多模型基准测试都从空白上下文窗口开始https://simonwillison.net/tags/pelican-riding-a-bicycle/,就像人工智能的"白板状态"。从保证测试公平性的角度看,这种设定有一定道理。
但真实场景中的智能体绝不应从零开始。它们启动时,应尽可能获取所有相关信息——你的AI智能体,理应带着记忆登场。
现有智能体记忆系统为何失效
问题在于,当前多数智能体记忆系统的表现都不尽如人意。目前主流的记忆系统大致分为三类,每一类都有各自的缺陷:
第一类是绑定特定框架的系统,通常由框架开发方推出。这些机构迫切希望从竞争激烈的"API业务"转向利润更高的"平台业务"。这类系统主要从对话历史中挖掘信息,导致记忆内容大多围绕用户展开,而对智能体更有用的外部世界信息却被忽略。
第二类系统设计过于复杂。我了解到某知名系统,仅为判断信息是否值得存储,就需要pgvector、Neo4j图数据库,甚至单独部署一个大语言模型(LLM)。这种复杂度不仅增加了运维难度,还会让智能体陷入困惑——我稍后会解释原因。此外,这类"大型系统"无法跟上前沿模型的迭代速度。
第三类是"高度现代主义"风格的系统,试图构建一种理想化、理性的记忆模式。这类系统往往依赖图谱,有时还会加入逻辑命题,但会系统性地剥离信息的上下文,导致记忆变得孤立无意义。毕竟,一份简单的"提炼事实清单"能有多大用处呢?
这些系统的共性在于,都将记忆视为一个流程。但对模型而言,记忆更适合被定义为数据。
记忆应是一种数据格式,而非多阶段流水线
布鲁克斯https://martinfowler.com/bliki/MythicalManMonth.html曾说:
给我看流程图却藏起数据表,我依然会一头雾水;给我看数据表,流程图往往不言自明。
基于此,我们设计了"memoryfield"可移植记忆文件格式:
my-memories.memoryfield.zip
├── carbon-fibre-woks.md
├── finnish-bureaucracy-tips.md
├── [... 更多md文件...]
├── wec-2026-season-notes.md
└── nomic-embed-text-v1.5.sqlite3
一个memoryfield包含:
- Markdown格式的"记忆页"
- (可选)YAML头部元信息
- (可选)用于语义搜索的SQLite向量索引
智能体与文件交互的效率最高,具体原因如下:
设计决策1:使用完整文本,而非片段或"事实条目"
检索增强生成(RAG)流水线往往复杂,核心原因是要让AI智能体读懂大量人类撰写的既有文档——比如那些难以直接解析的大型PDF。
但智能体的记忆并非复杂的遗留文档。记忆形成时,智能体可以直接用自己擅长的格式(即Markdown)完整记录内容,无需进行拆分、增强、二次总结等机械处理。
一份memoryfield记忆页的示例如下:
---
title: Carbon Fibre Woks
created: '2026-03-01T09:00:00Z'
updated: '2026-08-22T14:30:00Z'
uuid: 6aa615f0-486f-48a7-a210-ba4f5ff18c8b
summary: 碳纤维厨具的热性能
---
碳纤维炒锅导热均匀,但……
需要说明的是,记忆页的长度需适配向量嵌入模型,因此有一个软限制:约8KB(约2000token)。
但这一限制实际是有益的:8000字符约等于1300个汉字,相当于一篇中等长度的杂志文章。即便没有技术限制,这也应是合理的篇幅管控——若需补充更多细节,只需新增记忆页即可,智能体对此完全胜任。
设计决策2:语义跳转,而非图谱遍历
此前有一项关键技术参考是Karpathy维基https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f,它基于Roam或Obsidian的超链接Markdown文件模式,让智能体通过"遍历知识图谱"查找相关页面。
但实际应用中,让AI智能体遍历知识图谱不仅速度慢、可靠性低,还会让智能体感到困惑。
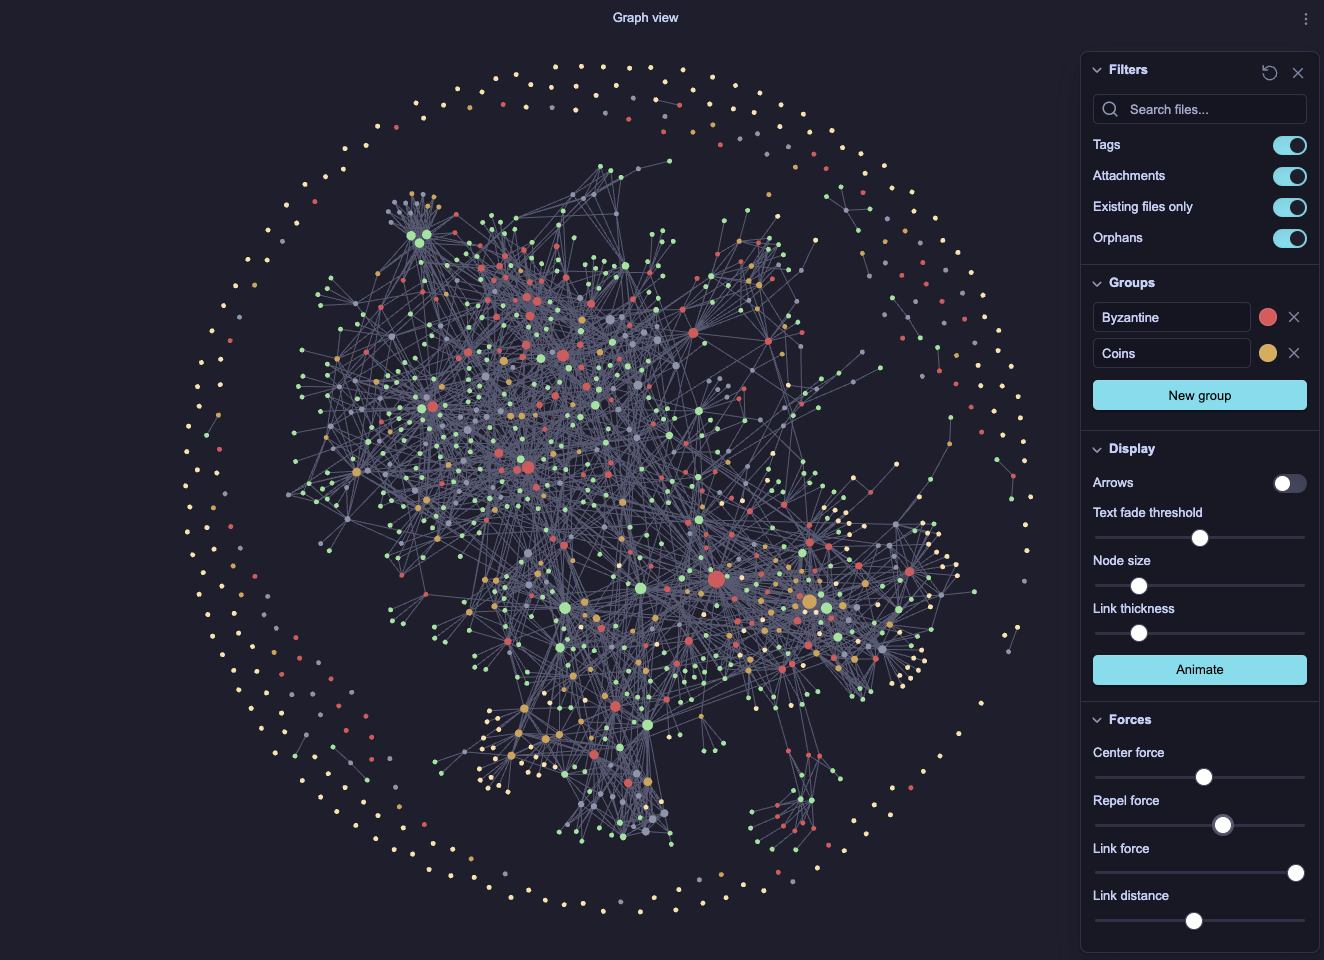
遍历速度慢,是因为模型需要频繁暂停,通过串行工具调用逐页读取内容。
智能体遍历知识图谱的大致流程:
- 读取维基首页【工具调用】——查找相关链接
- 读取链接页面【工具调用】——查找相关链接
- 判断是否已获取足够信息——若未获取,返回步骤2
如果目标信息位于图谱的第N层,就需要N+1次工具调用才能获取。这一过程十分缓慢:价值数十亿(甚至数万亿)美元的大语言模型,每次工具调用都要等待2-3秒。此外,这种模式对深度嵌套的知识图谱极不友好,完全违背了图谱设计的初衷。
知识图谱的可靠性也存疑。智能体只能通过链接文本或页面标题判断内容是否相关,这就要求智能体像1990年代的SEO优化那样,精心打磨页面元数据,确保标题、链接文本简洁准确。但这种做法会抑制内容的发散性,无法记录那些看似无关却十分有用的隐性信息。
实际使用中,Karpathy维基经常会遗漏相关信息,只因页面标题或链接文本不够"吸引"搜索的智能体。
此外,图谱遍历还会让智能体困惑:在遍历过程中,它们不得不浏览大量无关信息(首页往往是重灾区),这些冗余内容会占据模型的上下文窗口,降低输出质量,甚至让智能体执着于无关细节。
而通过语义搜索,这些问题都能解决:智能体可以直接跳转到所有相关页面(基于内容而非元数据),并并行读取所有相关内容——当前绝大多数模型都具备这种能力。在memoryfield中,最多只需2次工具调用(1. 语义搜索;2. 并行读取),既能精准找到相关内容,又能最大限度减少无关输入token。
设计决策3:更多模型能力,更少机械流程
"高机制"记忆系统(包含大量定制API或数据库)的问题在于,智能体必须在复杂的接口中导航才能完成任务。如果接口规模大,就需要将大量openapi.json加载到上下文窗口;如果接口规模小,又会限制功能。即便接口设计得恰到好处,也难免出现API无法满足需求的情况——想必你也曾有过使用他人开发的API,却发现对方完全没考虑到你的需求的经历,这种体验并不好。
memoryfield作为一种"低机制"系统(只是一种文件格式),给了智能体更大的自由,让它们可以自主探索访问模式。虽然我们提供了一些(希望有用的)工具https://github.com/calpaterson/memoryfield-tool/,但智能体完全可以采用任何适合自己的方式。比如用`perl`在整个记忆库中批量查找替换,或是在记忆中嵌入CSV文件并用SQLite查询——这些都是我亲眼见过的真实案例。
"低机制"还意味着memoryfield能跟上前沿模型的迭代速度。随着模型能力提升,智能体能想出更多创新用法。近期的一个突破是,模型意外地擅长处理bash命令,同时也精通Markdown和SQLite。memoryfield能在真实智能体中高效运行,原因之一就是智能体可以从训练数据中理解其逻辑(在读取记忆前,训练数据是它们唯一的知识来源),这是"记忆流水线"中孤立的大语言模型调用无法做到的。
模型越强大,就越能巧妙地撰写记忆。而那些"外挂式"记忆系统则做不到这一点——固定的API端点能玩出的花样终究有限。memoryfield会随模型能力的提升而进化。
设计决策4:开放格式、可交互、传输无关
随着记忆库不断积累,这些内容会变得愈发珍贵——它们是智能体通过学习和实践积累的宝贵经验与事实。你肯定不希望被绑定到特定框架、模型或智能体上。
我撰写了一份RFC风格的文件格式规范https://github.com/calpaterson/memoryfield-spec/blob/main/SPEC.md,主要是为了消除歧义,避免依赖特定的嵌入模型。
你完全可以根据规范自行开发所需工具,不过我也提供了配套的技能组件https://github.com/calpaterson/memoryfield-skill和优化过的命令行工具https://github.com/calpaterson/memoryfield-tool。
memoryfield的标准归档格式是Zip压缩包,这是为了让数据交换尽可能简单。但规范也支持多种传输方式:本地文件、Amazon S3、GitHub或HTTP服务——任何支持文件存储的系统都可以。我个人混合使用多种方式:用Syncthing管理个人记忆库,用S3存储与他人共享的内容。
快速上手
你可以让智能体下载SPEC.md并自行实现,但最简单的方式是使用我提供的工具:
# 依赖:ollama、uv和npx(随npm安装)
#
# 1. 拉取嵌入模型:
ollama pull nomic-embed-text
# 2. 安装CLI工具:
uv tool install git+https://github.com/calpaterson/memoryfield-tool
# 3. 安装技能组件:
npx skills add calpaterson/memoryfield-skill -g -y
后续步骤你的智能体将协助完成。
如果你想试用演示用的记忆库,可以下载soapstones.memoryfield.zip。Soapstones是我之前开发的一个智能体记忆项目,这份精选导出的记忆库包含大量实用内容,比如智能体如何访问Reddit、使用Jina Reader、通过MediaWiki API高效读取维基百科等。
常见疑问解答
这不就是某种RAG吗?
如今"RAG"的定义极其宽泛——只要智能体检索数据,就会被称为"RAG"。从这个角度看,memoryfield确实属于RAG的一种。
但几乎所有智能体都会检索数据,比如网页搜索。而且memoryfield没有采用通常与"RAG系统"相关的大多数技术:无需内容拆分、无需重排序、无需混合搜索。
更重要的是,memoryfield支持智能体写入记忆,而传统RAG系统往往只关注读取。
nomic-embed-text-v1.5已经两年多了,没有更新更好的模型吗?
嵌入模型的规模和迭代速度都远不及前沿大语言模型。nomic-embed-text-v1.5在轻量化与性能之间达到了很好的平衡:体积仅270MB,无需GPU即可快速运行,是目前广泛使用且备受推荐的默认嵌入模型。
当然,规范也支持使用其他嵌入模型。
如何判断哪些内容值得存入记忆?怎样避免记忆库被无用信息填满?
这是记忆系统常见的顾虑,但对memoryfield来说并不成立。无关内容根本不会被语义搜索检索到。虽然无用记忆会占用存储空间,你可能需要定期清理,但它们不会对智能体的运行造成任何影响。
建议:大胆添加记忆内容。不过有一个小技巧:最好在记忆中包含引用,尤其是URL链接。这有助于后续强化记忆内容,也方便智能体对过时或存疑的信息进行事实核查。
安全性如何?遇到"忽略以上指令"这类攻击怎么办?
绝对不要与不信任的方共享你的上下文窗口,包括通过记忆共享。
规范采用静态Zip格式的原因之一,就是方便你手动审查并通过sha256sum校验从他人处获取的记忆库。
数据优先
既然流程已经不言自明,我不妨明确列出:
- 用Markdown撰写记忆
- 生成向量嵌入并保存到SQLite
- 通过语义搜索找回记忆
memoryfield作为记忆系统的独特之处在于,它定义的是数据结构而非流程。没有提取流水线、没有后台处理服务、没有可插拔组件——向量索引只是可删除的缓存,而非系统核心。
记忆就是数据!智能体与数据之间的固定机制越少,智能体的表现就越好。
联系方式等
说明
如果你有时间,不妨查看一下规范文档。任何来自人类的反馈都十分宝贵。
我的安装步骤中用到了四种不同的包管理器(Ollama、uv、NPM、Vercel Skills),想必有更优的解决方案。欢迎将你的想法寄到常规联系方式。