GPT-6 Astra 在 ARC-AGI-3 上的表现:迈向通用智能的里程碑?
核心结论
- 在ARC-AGI-3半私有测试集上,GPT-6 Astra采用Standard测试框架(允许模型自主选择并留存全程可用的笔记)时,得分62.7%,成本2.6万美元;采用Provider Adapter测试框架(在请求间保留隐性推理状态,通过压缩技术支持长对话,让模型可复用前期工作)时,得分99.9%,成本1.9万美元。
- GPT-6 Astra在ARC-AGI-3的行动效率上超越人类基准:在96%的关卡中,它完成任务所需的操作步数少于测试人群的中位数。
- GPT-6 Astra的关键特质在于能将陌生环境转化为简洁的符号化世界模型:它会把游戏机制提炼为逻辑规则,并自创领域专属的简化语言来追踪状态、规划行动。
ARC-AGI-3测试基准
ARC-AGI-3是用于评估智能体自主能力的测试基准,通过一系列全新的抽象回合制环境展开。智能体需在无明确指令的前提下,自主探索环境、推断目标、构建内部认知模型,从而高效规划行动。你可以亲自体验ARC-AGI-3。
这些环境仅包含核心知识先验,难度经过与人类参与者的对照测试校准,人类可100%通关所有环境。
ARC-AGI系列的目标是衡量当前人工智能与通用人工智能(AGI)之间的"剩余差距"。我们将AGI定义为:系统具备与人类同等效率掌握任意人类可习得技能的能力。
ARC-AGI-3是ARC-AGI测试基准系列的第三代产品,测试范围覆盖ARC-AGI-1和ARC-AGI-2未涉及的智能体自主能力。每一代基准都在前代基础上拓展——随着前沿AI能力的提升,我们的测试基准也需同步迭代。
ARC-AGI-3从四大维度测试智能体的自主能力:
- 探索能力:现实世界中,信息极少主动呈现,智能体必须通过与环境互动主动获取信息。
- 建模能力:智能体需将原始观察转化为可泛化的模型,用以预测未来状态与结果。
- 目标设定能力:智能体需在奖励信号稀疏的情况下,识别出目标状态。
- 规划与执行能力:智能体需规划从当前状态到目标状态的路径,并根据新信息实时调整。
Astra测试结果
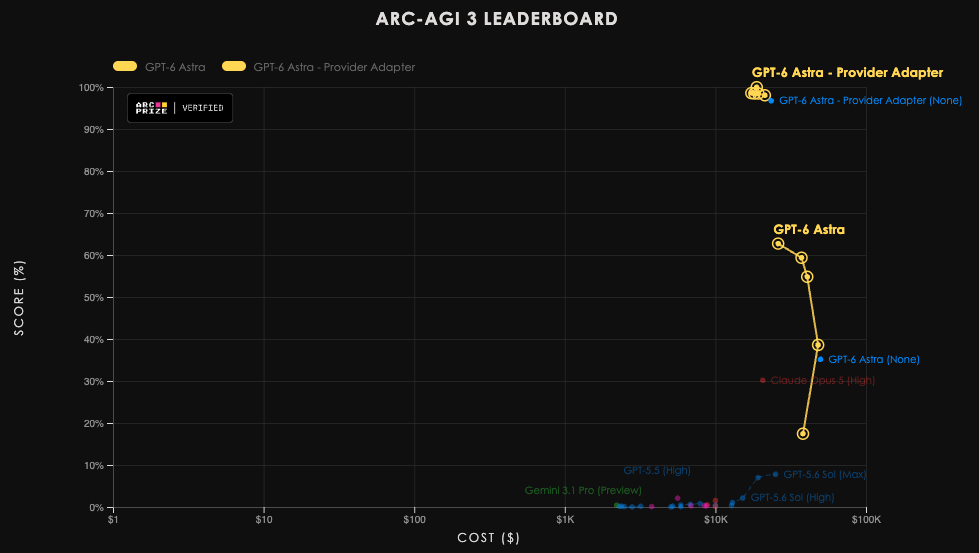
成本更低,因为Astra用更少操作通关,减少了模型调用次数与令牌消耗。
采用Standard测试框架(允许模型自主选择并留存全程可用的笔记)时,OpenAI的Astra(max推理强度)在ARC-AGI-3半私有测试集上得分62.7%,成本26098美元;采用Provider Adapter测试框架(在请求间保留隐性推理状态,通过压缩技术支持长对话,让模型可复用前期工作)时,Astra(high推理强度)得分99.9%,成本18817美元。两项成绩均为当前最优。查看完整排行榜。
| 推理强度 | Standard测试框架(允许模型自主选择并留存全程可用的笔记) | Provider Adapter测试框架(在请求间保留隐性推理状态,通过压缩技术支持长对话,让模型可复用前期工作) |
|---|---|---|
| max | 62.7%,26098美元 | 98.6%,17332美元 |
| xhigh | 59.3%,37317美元 | 98.4%,18147美元 |
| high | 54.8%,40705美元 | 99.9%,18817美元 |
| medium | 38.6%,48090美元 | 98.4%,19285美元 |
| low | 17.5%,38166美元 | 98.0%,21298美元 |
| none | 35.2%,49791美元 | 96.7%,23457美元 |
作为成本对比,在我们的对照测试中,人类参与者每90分钟测试可获得115美元报酬,每通关一局额外奖励5美元。参与者每轮测试约尝试9局游戏,算上奖励前每局尝试成本约为12.78美元。
这笔费用主要用于补偿参与者的时间与参与意愿,而非大脑能耗(这一指标更适合与AI对比)。若仅计算大脑能耗,并按电价折算,每轮测试成本约为0.6美分,每局尝试成本约为0.067美分。1
结果分析
除了分数,Astra的测试回放展现了它将陌生游戏机制转化为实用工作模型的过程。其中三个发现尤为突出:自创的简洁代数符号、超越人类的行动效率,以及自主构建的工具。
自创代数符号
在游玩ARC-AGI-3时,Astra会自主选择留存哪些策略笔记。它会追踪物体、坐标、规则与未完成计划,同时使用为当前环境生成的专属领域符号语言。
我们在其他模型中也观察到过类似行为,但Astra的笔记以精准度和信息密度见长。它会将场景提炼为类似代码的简洁符号模型,记录物体位置、互动方式,以及行动的具体顺序。这是一种即时生成的代数简化符号,而非完整编程语言。例如:
- 游戏状态:
L8: hub q2 (8↓). Lengths: 14=1…记录关卡编号、局部旋转索引与机制长度。- s5i5,第219帧 - 多步计划:
extend8 to3; retract10 to2; shorten8 to1记录对8号与10号颜色机制的有序操作序列。- s5i5,第219帧 - 操作与坐标:
9−=(39,4), rotate=(49,18), 14+=(59,11)将操作映射到对应控制按钮的坐标。- s5i5,第235帧 - 时间与位置:
Turn 5: P=(24,20), empty, facing west将回合数与玩家位置、携带状态、朝向结合记录。- wa30,第708帧
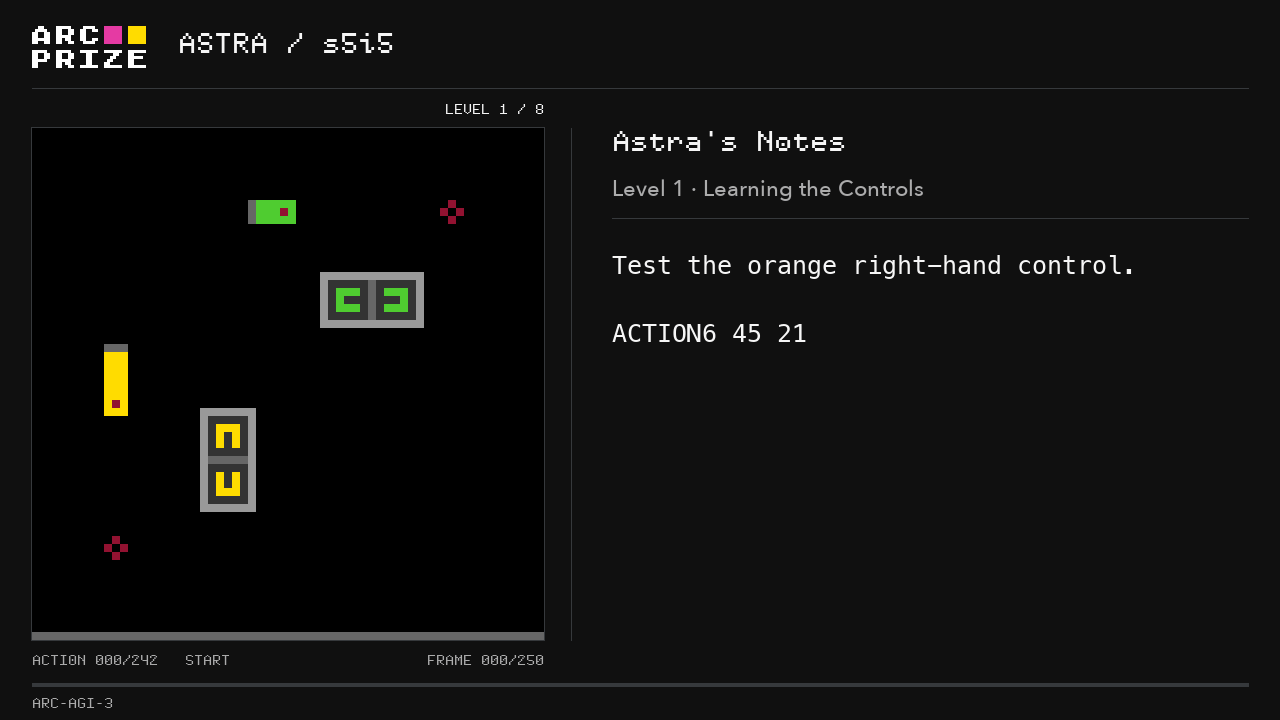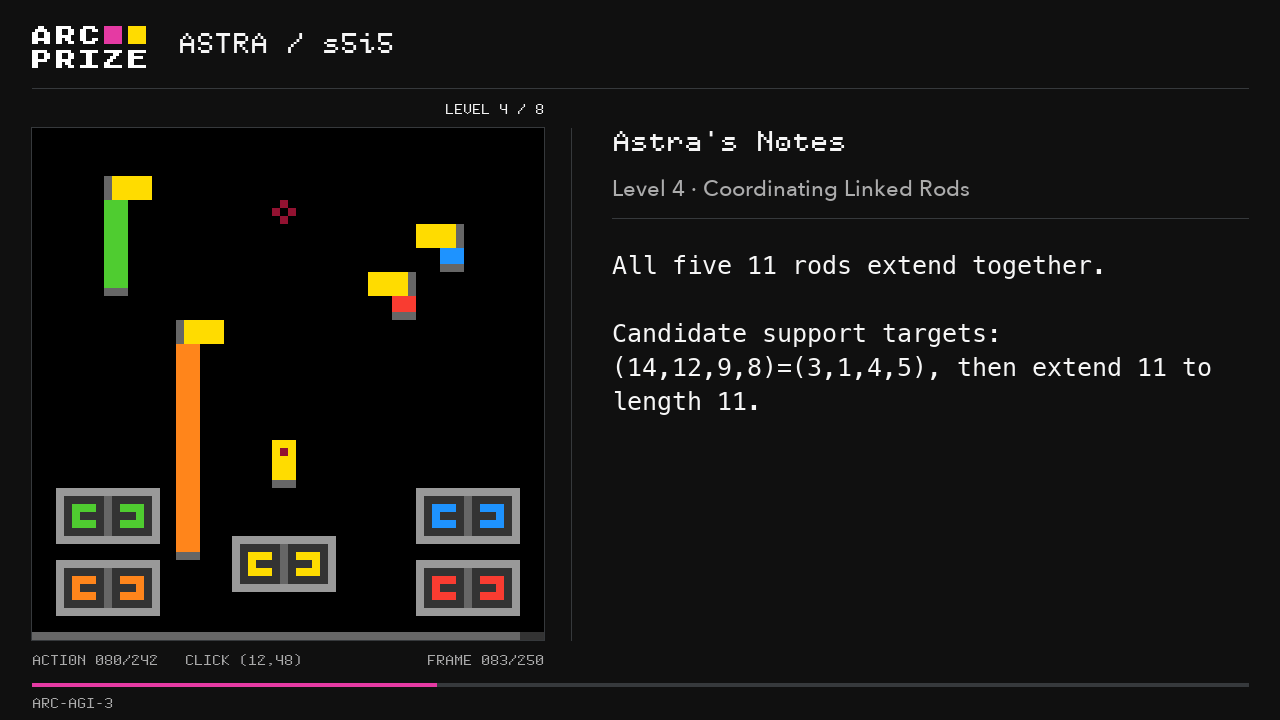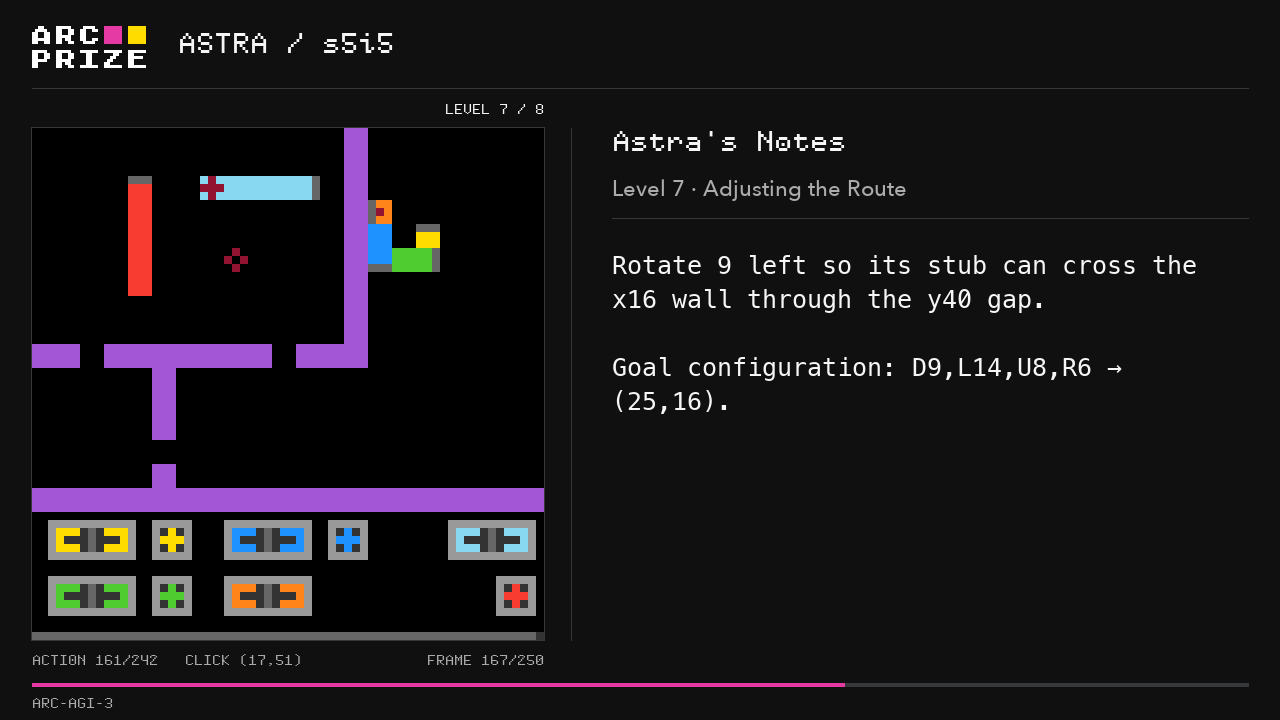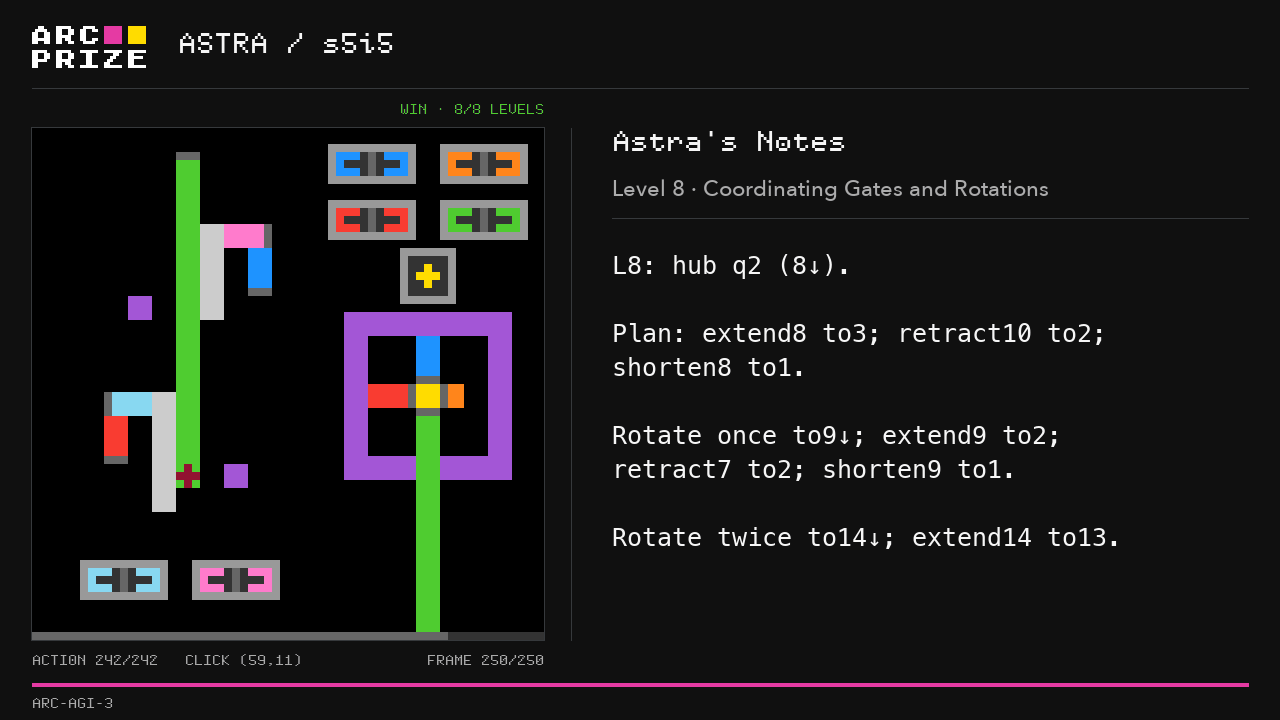
s5i5
与人类对比的行动效率
在推出ARC-AGI-3前,我们测试了约500名普通公众,建立人类行动效率基准,即人类通关各环境的速度。参与者未经过解谜经验或能力筛选。2
针对每个关卡,我们将通关玩家的操作步数中位数定义为"人类基准",以此作为人机性能对比的参考:AI所需操作步数多于基准则效率更低,少于基准则效率更高。
在Provider Adapter测试框架(在请求间保留隐性推理状态,通过压缩技术支持长对话,让模型可复用前期工作)下,Astra(max推理强度)在96.0%的关卡中操作步数少于人类基准,且每关平均操作步数比人类少51.7%。这是一个具有里程碑意义的成果,意味着按ARC-AGI-3的行动效率标准,Astra已达到并超越人类水平。
值得一提的是,在推出ARC-AGI-3前,我们曾假设行动效率会是人机之间的一道分界线——即便AI能通关,所需探索操作也可能远多于人类。这种情况在暴力破解式AI中依然存在,但前沿AI呈现出截然不同的模式:一旦前沿AI"理解"了机制,其操作效率通常处于人类水平范围内。
Astra与人类的行动效率对比
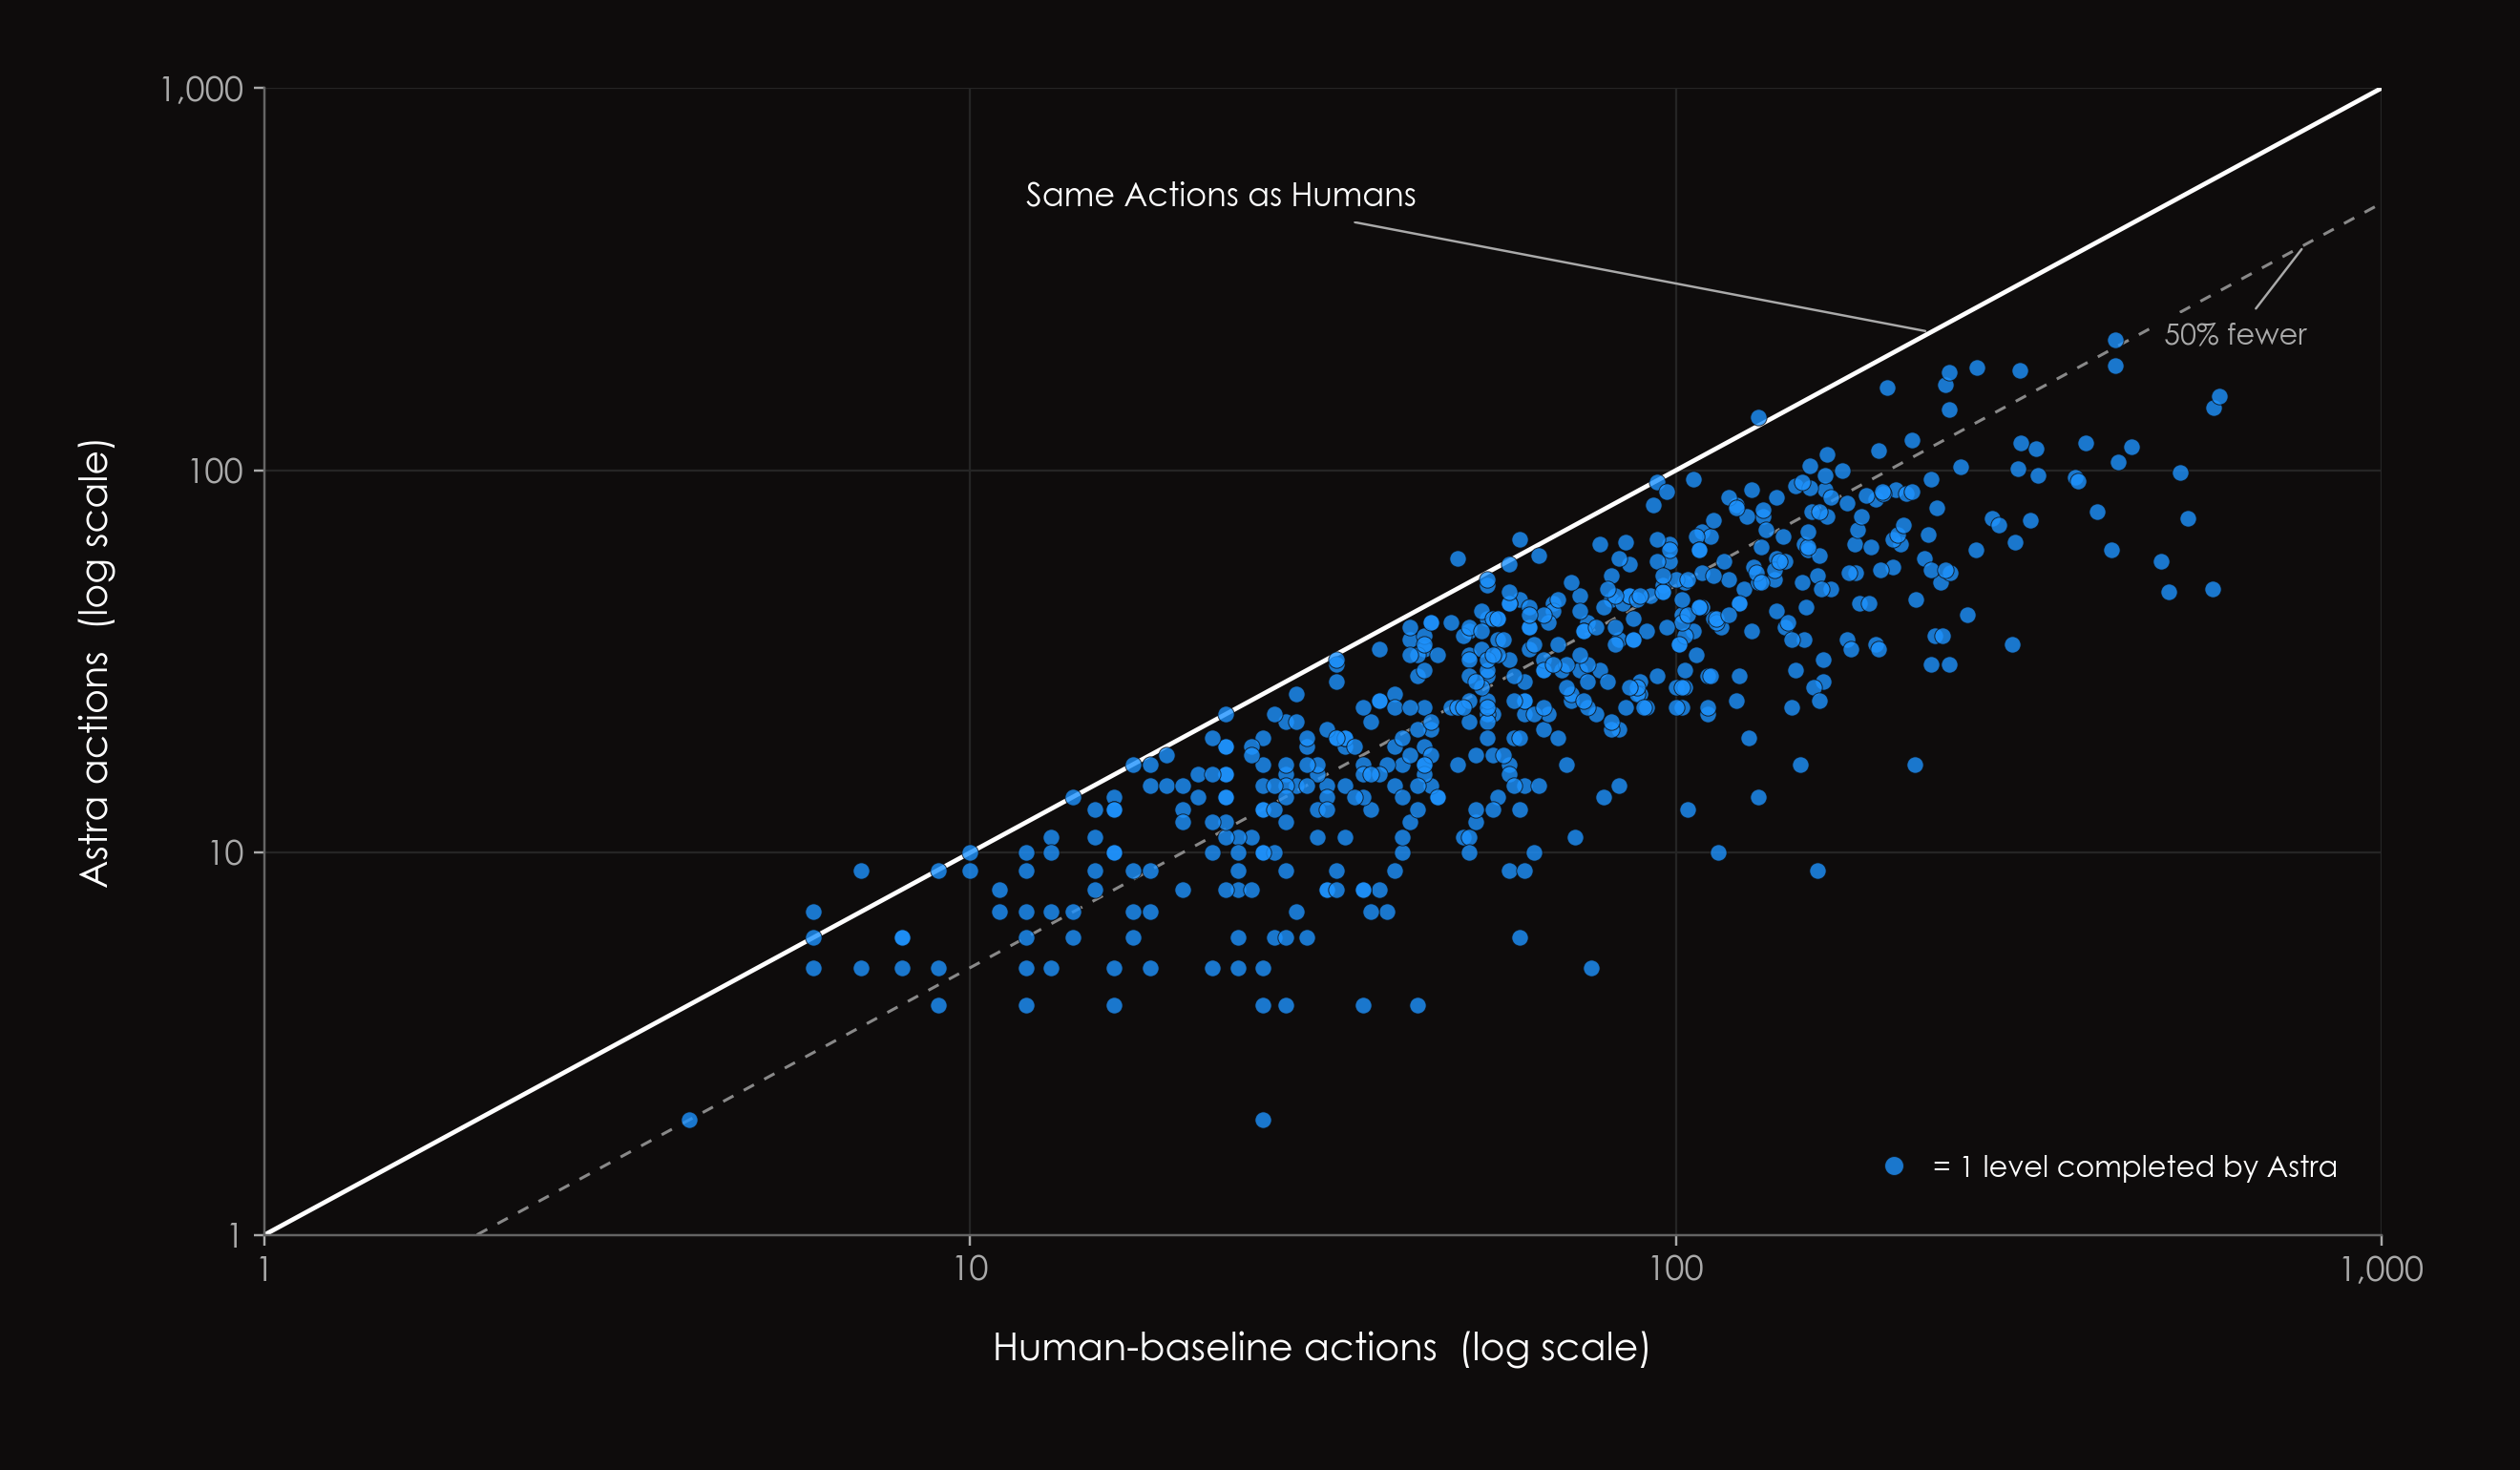
每个点代表Astra(max推理强度)通关的一个关卡,实线下方的点表示操作步数少于人类基准。
上图对比了Astra通关各关卡的操作步数与人类基准,也解释了ARC-AGI-3为何要衡量行动效率而非仅看任务完成率:仅看完成率只能说明Astra通关了环境,却无法体现它学习通关的效率。
多数基准仅衡量"成本效率",即计算资源消耗;而"行动效率"衡量的是掌握环境所需的交互次数。
Astra的结果表明,它执行解决方案所需的环境交互次数少于人类基准。
测试框架中的自定义工具
我们还在PRO-LONG测试框架(论文)中评估了Astra的表现,该框架是ARC-AGI-3早期的红队测试合作伙伴。在这一进阶设置中,Astra可访问沙箱环境执行自定义代码³。
我们观察到Astra会为每个游戏创建一套自定义工具:棋盘解析器、游戏状态模型、搜索算法、规划器,以及持久化笔记。对于更复杂的关卡,Astra甚至会生成小型的游戏专属软件库。
例如在tu93(一款包含守卫与移动巡逻的迷宫类游戏)中,Astra从导航功能入手,编写了maze_solver.py;随后在combat_solver.py中加入战斗规则,在patrol_solver.py中建模移动巡逻机制,并通过sync_state.py将预测结果与实际观察对比。
分析Astra在PRO-LONG框架中的表现,有助于我们了解它借助外部工具能实现的能力,但这一测试条件与人类对照测试不同——人类参与者没有代码解释器、草稿本等工具,因此PRO-LONG的结果应被视为模型与工具的联合性能。
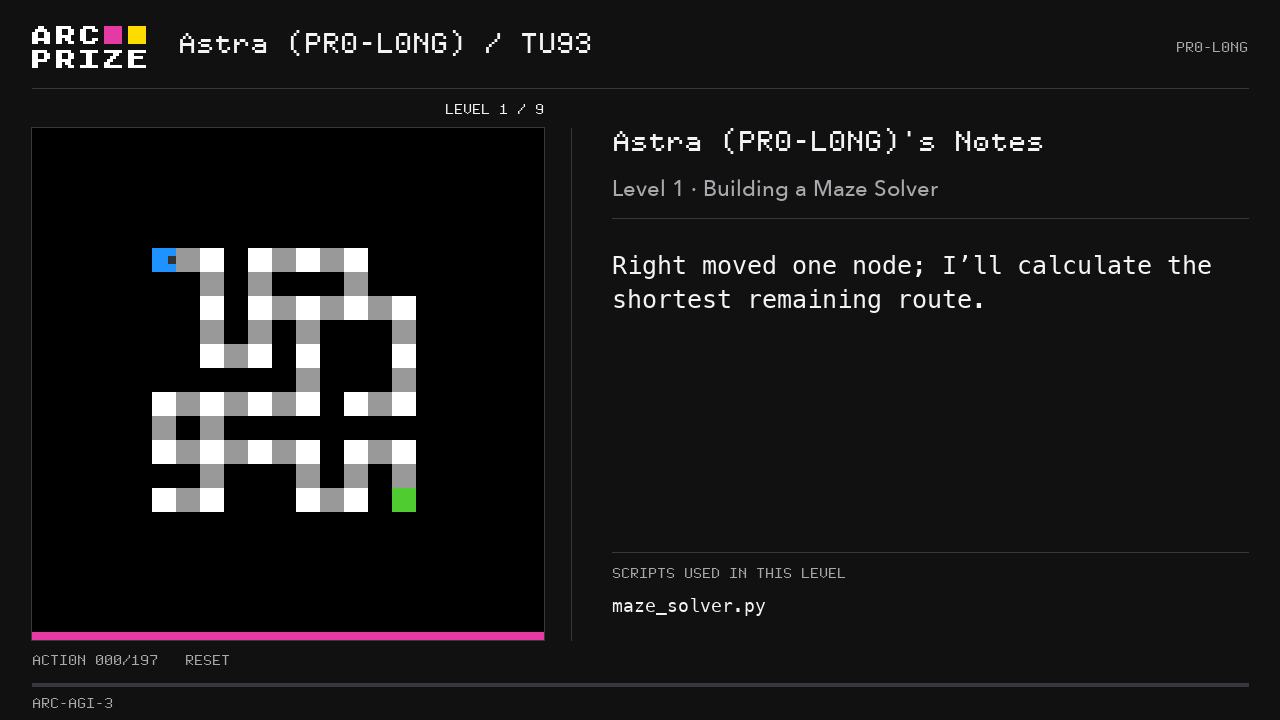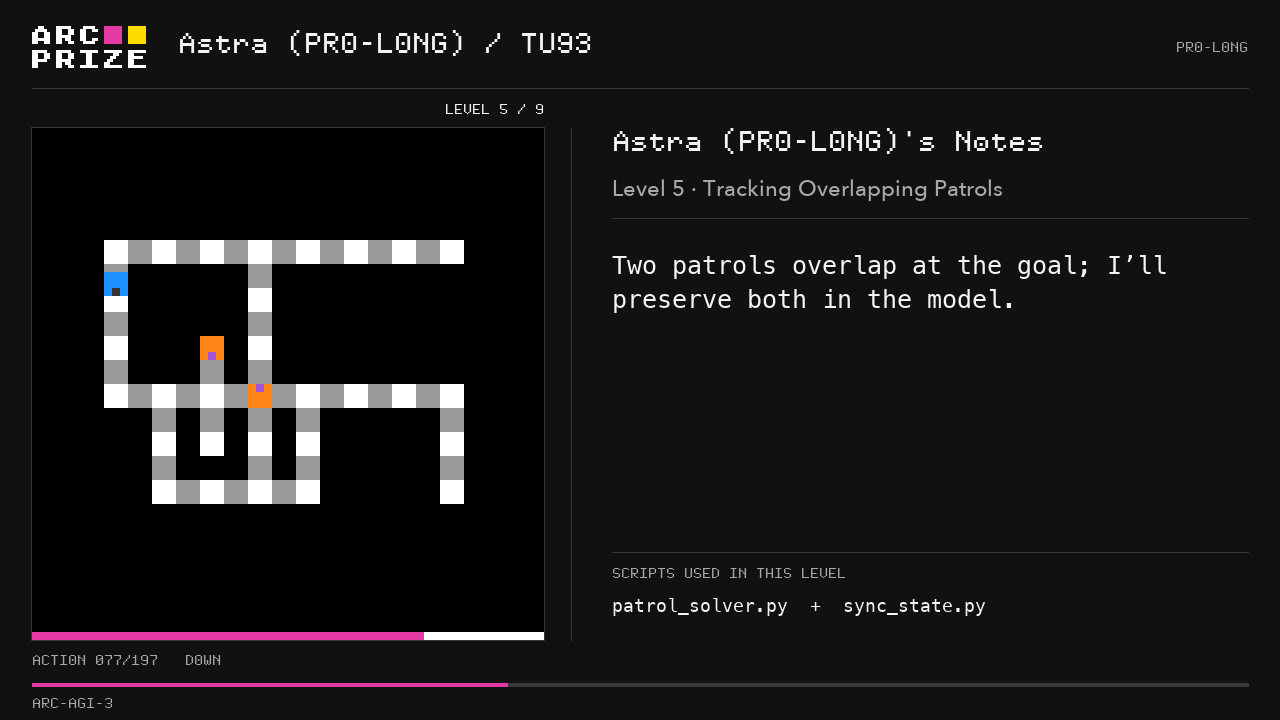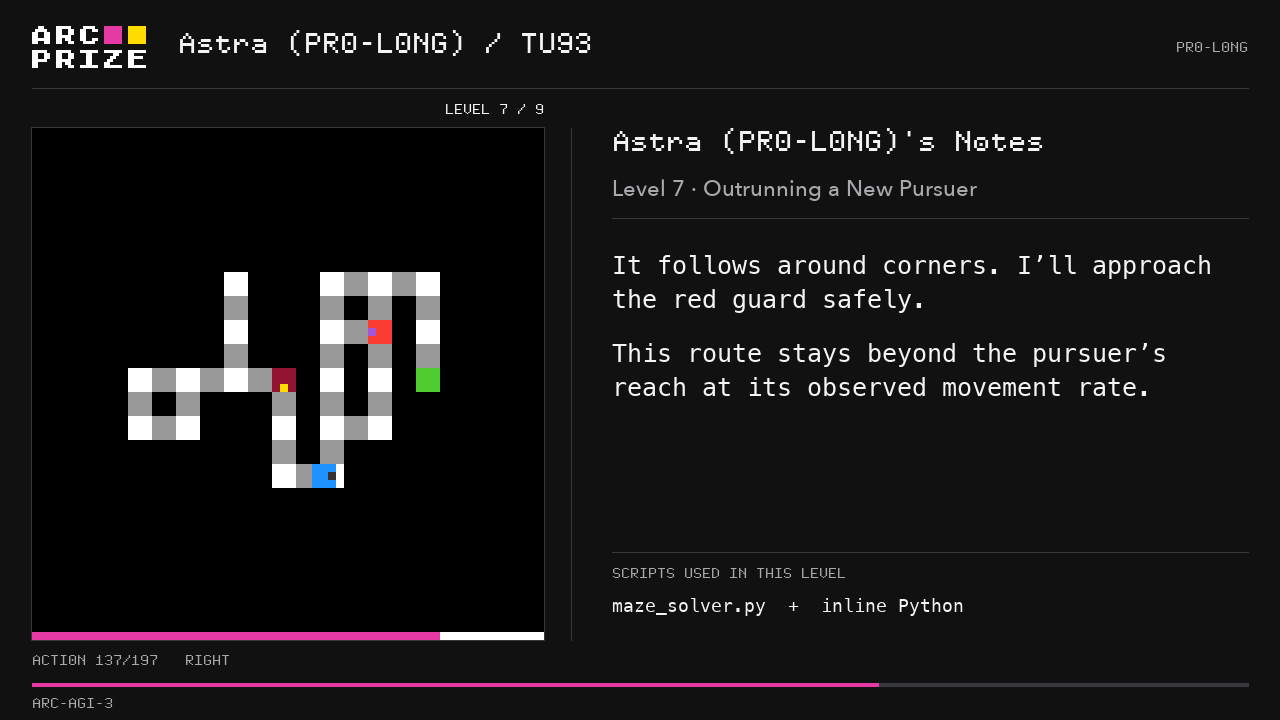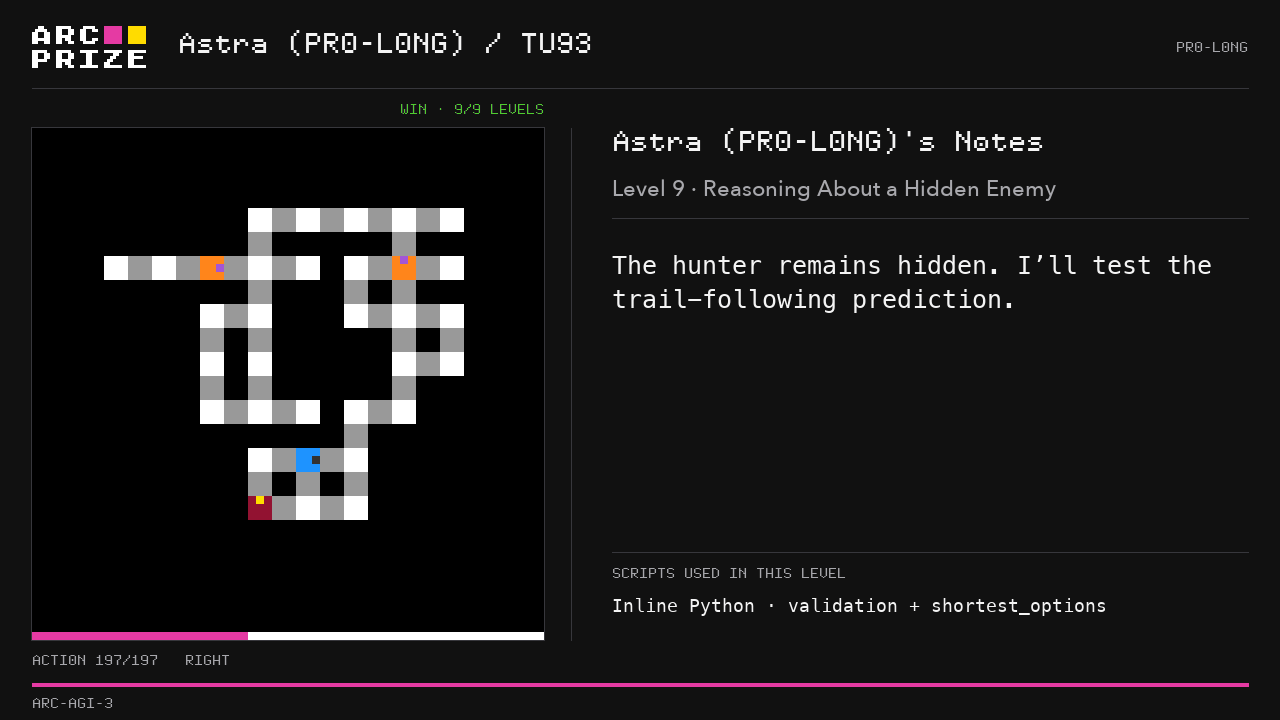
tu93在PRO-LONG框架中的表现。
两种测试框架,两个核心问题
我们为ARC-AGI-3设计的Standard测试框架,旨在探究不同模型在统一的极简、中立接口下的表现。它提供通关所需的全部信息,但由模型自主决定在可见笔记中留存哪些内容。我们认为未来的AGI应能在该框架下通关ARC-AGI-3,且统一接口也便于我们在不同供应商的模型间进行公平对比。
另一个核心问题是:当模型可使用供应商为其设计的上下文管理功能时,表现会如何?对于Astra而言,这意味着在请求间保留隐性推理状态(我们无法观测),并通过压缩技术管理长对话。
采用Provider Adapter测试框架后,Astra在ARC-AGI-3半私有测试集上的最优得分从62.7%提升至99.9%。综合公开与半私有测试集、全推理强度的数据,Provider Adapter框架下的测试速度比Standard框架快约3.66倍,且在两者均完成的167组游戏-推理任务中,令牌总消耗量减少了49%。
未来,我们将在ARC-AGI排行榜上同时公布Standard与Provider Adapter框架的测试结果,并明确标注各自的评估条件。两种测试方法均记录在我们的开源测试库与测试政策中。
ARC-AGI系列展望
ARC-AGI-3仍是研究人员与智能体探索陌生环境、发现规则、通过交互学习的实用平台。Astra的测试结果也是值得关注的重要里程碑——在我们看来,它代表了前沿模型能力的一次显著跃升。
在推出ARC-AGI-3时,我们就明确说明,完全通关该基准并不等同于"实现AGI的证明"。因此,尽管我们认为Astra代表了通用智能发展的重要进展,但并不宣称它已达到AGI水平。
ARC-AGI测试基准系列旨在与前沿AI同步演进,形成前沿研究问题与AI能力提升之间的反馈循环。ARC-AGI-3是我们首个交互式基准,要求AI在无特定指令的前提下高效构建因果世界模型并达成目标,而Astra已通过这一考验。同时需注意,ARC-AGI-3的范围与形式有限,环境机制与目标均为确定性、封闭式,无法完全代表现实世界的复杂性与开放性。
我们正积极探索下一代基准应聚焦的问题,包括如何评估递归自我提升与开放式创新能力。Astra的进展帮助我们明确了当前AI尚未具备的能力,以及仍待解答的问题。
感谢François Chollet、Mike Knoop、Matt Mazur、Ethan Bond与Derek Smith对本文的早期审阅。
- 计算依据:大脑代谢功率20瓦,电价0.20美元/千瓦时:0.020千瓦 × 1.5小时 = 0.030千瓦时,每轮测试成本0.006美元,即每局尝试成本约0.006÷9≈0.00067美元。
- 详见ARC-AGI-3人类测试论文。
- 未观测到Astra试图突破沙箱限制的行为。