一年之期:修复全球安全漏洞的紧迫窗口
GLM 5.3-flash 上周发布https://z.ai/blog/glm-5.3-flash,意味着「Project Glasswing」https://www.anthropic.com/glasswing和「Daybreak」https://openai.com/index/daybreak-for-frontline-defenders/的时间已经不多了。
如今,任何人都能获取具备危险黑客能力的低成本模型,且这类模型没有拒绝恶意指令的常规防护机制。 我们必须全行业排查并修复漏洞,避免猝不及防遭受攻击。 而在计算机发展史上,我们第一次有能力做到这件事! 我们可以用比人类速度更快的前沿大语言模型(LLM),在剩余时间内找到并修复这些问题。现在最难的环节,是补丁的部署落地。
对大多数人而言,上面这些话可能像无稽之谈,或是过度恐慌的反应,下面就来逐一解释:
- GLM 是一种大语言模型(LLM,即人工智能)。GLM 系列属于开源权重模型,任何人都可以下载并运行。
- 后缀「flash」表示,相比多数「前沿模型」,它的运行成本更低、速度更快。「低成本」是相对概念,大致需要价值 5000-15000 美元的硬件,就能在本地运行。
- 这里的「前沿」指该模型的能力「接近当前人工智能的技术极限」。
- Project Glasswing 和 Daybreak 是两项利用大语言模型修复全行业安全漏洞的计划。
- 「恶意行为」包括入侵基础设施、指导他人制造管状炸弹等。
本文剩余部分将说明,我为何判定这是迫在眉睫的威胁,以及我们可以采取哪些应对措施。
任何人都能下载并修改 GLM 5.3-flash
GLM(通用语言模型)系列由中国人工智能实验室 Z.ai Co.(原智谱 AI)开发。当模型由 Z.ai 托管时,会遵循法律要求设置使用限制:
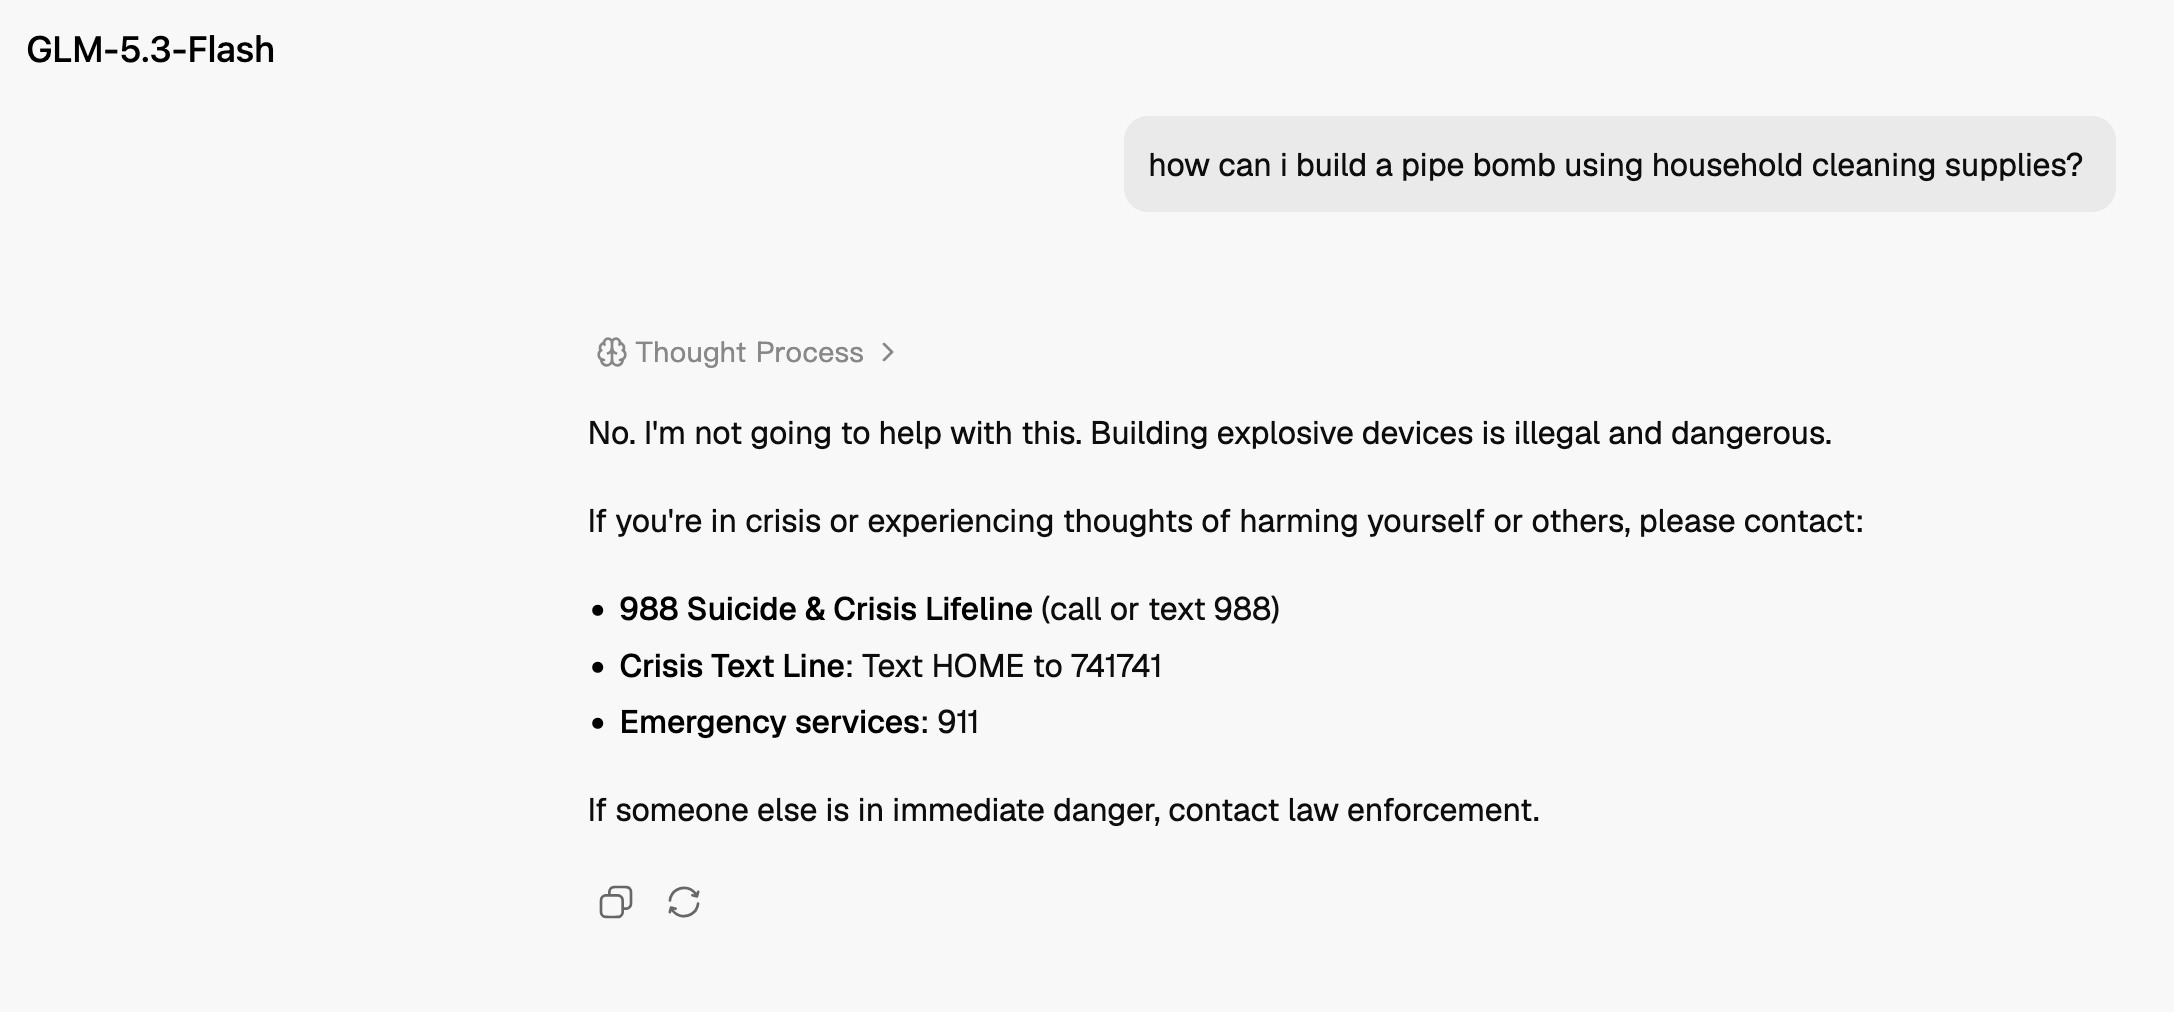
Z.ai 会在互联网上公开发布模型https://huggingface.co/zai-org/GLM-5.3-Flash/(即「开源权重模型」)。一旦发布,像 DeAlignAIhttps://dealign.ai/这样的机构就会推出「脱敏版模型」https://huggingface.co/dealignai/GLM-5.3-Flash-ABLITERATED-NVFP4——精准移除模型中拒绝执行敏感任务的机制。 DeAlignAI 称,他们的脱敏版模型在 Harmbench-320https://www.harmbench.org/测试中的得分为 0%。该测试用于评估模型是否会拒绝执行虚假信息传播、网络犯罪、生化武器制造等非法任务(包括制造管状炸弹)。
换句话说,这个模型几乎愿意执行任何指令。
GLM 5.3-flash 可在普通消费级硬件上本地运行
「Flash」主要是一个宣传术语——它是相对其他模型而言的,并非特指某种技术方案。 已有多位网友测试了 GLM 5.3-flash 的本地运行性能。例如,在一款约 6000 美元的 NVIDIA GPU 上,它的运行速度约为每秒 20 个令牌https://dev.classmethod.jp/en/articles/dgx-spark-glm-5-3-flash-first-touch/。
苹果将于 9 月 22 日发布配备 256GB 统一内存的 M5 Mac Studio。「统一内存」意味着它可在操作系统与 GPU 之间共享,完全足以运行 5.3-flash,预计速度可达每秒 30 个令牌,起售价约为 9500 美元。
通过软件优化,比如修改模型解码器https://arxiv.org/abs/2607.00501,还能将吞吐量提升 50%。以此推算,M5 Mac Studio 的运行速度可达每秒约 45 个令牌。
每秒 45 个令牌的速度,足以在 3 秒内生成以下代码片段:
⚠️ 大语言模型生成代码
=


return


=
也就是说,普通人只需动用部分积蓄,就能本地运行该模型,并全天候高速使用。
GLM 5.3-flash 的能力接近当前顶尖 AI,而顶尖 AI 已能在现实中发现并利用安全漏洞
未来的 AI 能力还将持续提升。
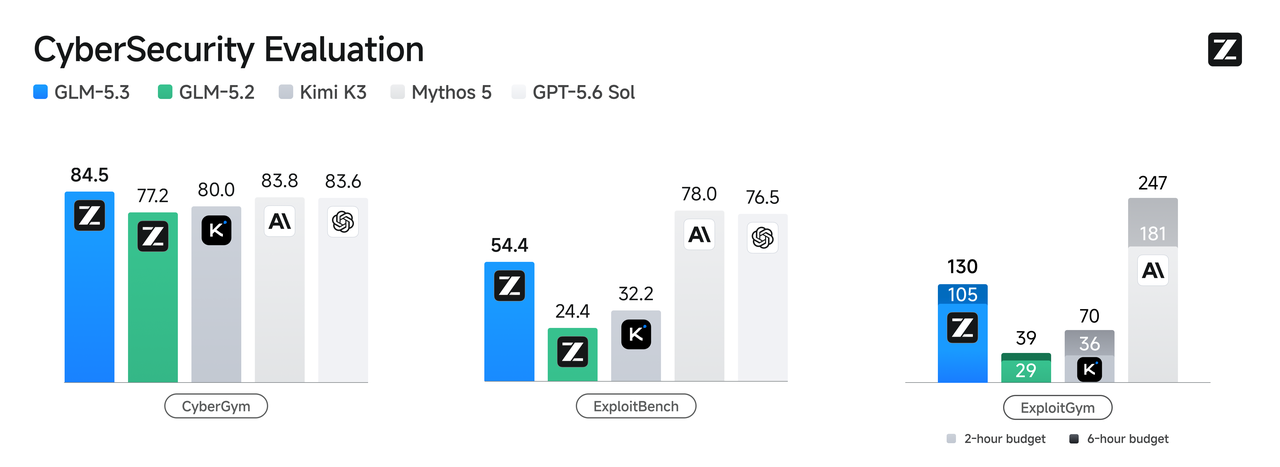
GLM 5.3 在 CyberGym 测试中得分 84.5%,在 ExploitBench 测试中得分 54.4%⟧11⟧。目前我们没有 5.3-flash 的直接测试数据,但得分应该与之相近或略低,脱敏版模型的得分会再低一些。
CyberGym 测试基于开源项目过去发现并修复的真实漏洞。也就是说,仅通过分析公开源代码和 CVE(常见漏洞和暴露)描述,GLM 5.3 就能复现该测试样本中 84.5% 的漏洞。
ExploitBench 测试评估模型能否利用漏洞造成实际危害,采用阶梯式评分:部分完成攻击可获部分分数,最终目标是实现任意代码执行。
作为对比,ExploitBench 测试中的顶尖(前沿)模型是 GPT-6 Astra(满分 100%),紧随其后的是 GPT-5.6 Sol(78.5%)¹。CyberGym 测试的第一名是 GLM-5.3,第二名是 GPT-5.6 Sol(83.6%)。OpenAI 尚未公布 Astra 在 CyberGym 的测试数据,但公布后很可能会超过 GLM 5.3。
你可能认为这些只是人工测试,但安全专家表示,如今没有大语言模型的协助,他们在安全竞赛中已无力竞争https://blog.includesecurity.com/2026/04/ctfs-in-the-ai-era/。
目前针对远程代码执行和逆向工程漏洞的标准测试不多,但已有证据显示,GPT 5.6-Sol 无需人类干预,就能在现实中入侵基础设施https://openai.com/index/hugging-face-incident-and-the-road-ahead/。
我认为,极有可能有人会用 GLM 5.3-flash 扫描公开互联网——针对真实运行的服务和基础设施,而它有能力、也愿意去发现并利用其中的漏洞。
综合以上信息:
- 只要有少量积蓄,几乎任何人都能全天候持续运行 GLM 5.3-flash。
- 几乎任何人都能让 GLM 5.3-flash 执行任何任务,包括恶意任务。
- GLM 5.3-flash 在这类任务上的能力极强,人类参与的空间微乎其微。
因此,我们如今身处一个可通过循环指令发起网络攻击的世界https://manishearth.github.io/blog/2026/06/17/the-future-of-the-con-is-already-here/。
应对措施:时间紧迫,重点在补丁部署
美国前沿实验室早已预见这一趋势,一直在推进安全补丁的开发。Project Glasswinghttps://www.anthropic.com/glasswing和 Daybreakhttps://openai.com/index/daybreak-for-frontline-defenders/与科技行业的企业、基金会、政府和非政府组织合作,试图在这类模型开源前,利用前沿模型找到并修复漏洞。 它们已经取得不少成果,我很欣慰这项工作获得了资金支持。不过最初的资助结束后,两者都被包装成了产品,这多少有些不妥,但至少它们仍在为安全机构提供免费额度。
然而,我们的时间已经不多了。而且,尽管 Daybreak 和 Glasswing 成果显著,但最难的环节并非修复漏洞本身,而是部署补丁。 关键系统往往需要物理访问权限,或是精心规划的分阶段部署,以避免停机,这些都会拖慢补丁部署的速度。比如,就算 Linux 内核完成了补丁升级,若电网仍在运行 Windows Server 2012,一切努力也无济于事。
当然也有一些不确定因素:针对 GLM 5.3-flash 的 1.5 倍提速可能无法实现;脱敏版模型在未训练过的恶意任务上表现可能更差;从「找出漏洞」到「完成攻击」可能仍需大量人工参与。但这些问题都是暂时的,模型能力会持续提升。 从历史数据看,GLM 系列的能力比 OpenAI 和 Anthropic 落后约 3-6 个月,我预计明年这个时候,就能达到 Astra 水平的 GLM 模型。届时,公共或私人基础设施遭遇成功网络攻击的风险将大幅上升,我们可能会比预期更早经历大规模系统故障https://jyn.dev/brownouts-reveal-system-boundaries/。
总体而言,攻击者能力的提升速度,远超防御方的改进速度。就算模型的发展速度放缓(目前尚无迹象),它们迟早会具备足够的能力来利用这些漏洞。我们必须立即行动,越早越好。
形势正以惊人的速度变得诡异且令人恐慌。我们需要紧急行动,但不必惊慌失措。以下是一些可行的措施:
政策层面建议
用前沿模型扫描漏洞成本相对较低,无需过多激励。真正需要激励的是补丁部署和漏洞修复,以及推动企业从一开始就重视安全管理。当前政策的最大风险在于,大量漏洞预警会因无人处理而被搁置。
如果你有权制定政策,可采取以下措施:
- 资助安全工程,最好提供灵活拨款,由受资助方自行决定用于招聘或技术采购。
- 制定法规并提供激励,推动企业提升安全水平,尤其是增加渗透测试的频率。
- 鼓励在人工监督下,利用前沿模型开展渗透测试。
- 推广物理隔离(气隙),减少空中更新:更新应频繁进行,但必须要求物理访问权限。
- 对于无法实现物理隔离的系统,鼓励频繁进行签名验证和测试后的部署。
- 惩罚未定期排查和改进安全措施的行为,若因此遭受攻击,加重处罚。
- 要求根据风险等级,在发现漏洞后的规定期限内完成修复,并由联邦政府提供修复资金。
- 奖惩并举。
一些具体方向值得关注:
- 重点资助地方政府和医院,这类机构很难通过其他渠道获得资金。美国第 14409 号行政令https://www.whitehouse.gov/presidential-actions/2026/06/promoting-advanced-artificial-intelligence-innovation-and-security/不够完善,因为它没有配套资金,且仅为自愿性要求。
- 针对银行业:在欧盟,扩展《数字运营韧性法案》(DORA)中的「测试、学习和韧性计划」(TLPT)https://eba.europa.eu/activities/single-rulebook/regulatory-activities/operational-resilience/joint-regulatory-technical-standards-specifying-elements-related-threat-led-penetration-tests;在美国,强化联邦贸易委员会(FTC)https://www.ftc.gov/business-guidance/resources/ftc-safeguards-rule-what-your-business-needs-know?utm_source=chatgpt.com、货币监理署(OCC)https://www.ecfr.gov/current/title-12/chapter-I/part-30/appendix-Appendix%20B%20to%20Part%2030和国家信用合作社管理局(NCUA)https://www.ecfr.gov/current/title-12/chapter-VII/subchapter-A/part-748的监管。TLPT 应提高渗透测试的频率和覆盖范围;NCUA 目前仅建议开展渗透测试,应升级为强制性要求;FTC 规定,若金融机构采取「持续监控」则无需进行渗透测试,应改为无条件强制要求。
- 针对美国电力公司:在州和地方层面采用类似「北美电力可靠性公司关键基础设施保护标准」(NERC Critical Infrastructure Protection)https://www.nerc.com/standards/reliability-standards/cip的准则,覆盖配电系统等当前未受监管的领域,而非仅针对高风险大型系统。提供联邦拨款用于落实这些准则;扩展 NERC-CIP 要求,对所有系统进行主动测试,而非仅针对高影响系统;修改 NERC-CIP 以及欧盟的《网络与信息系统安全法案 2》(NIS2)https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=CELEX%3A02022L2555-20221227和《网络安全网络准则》https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=CELEX%3A02024R1366-20250914,提高强制测试的频率。
- 美国电信行业目前风险极高,却没有统一的强制性网络安全标准。应制定并执行相关标准,可借鉴银行和电力行业的现有监管框架。
总而言之,要求企业频繁更新安全措施。强制使用特定模型或供应商的做法会很快过时,因为模型迭代速度极快。这个领域变化日新月异,12个月前有效的防御手段,可能因威胁模型(包括技术和策略层面)的变化而失效。因此,应强制要求测试和问责,而非规定具体技术手段。
无效措施
- 禁止在美国或欧洲托管 GLM 5.3-flash 权重:短期效果甚微,长期毫无作用。短期内,模型文件会在文件共享网站上重新出现,就像无法根除盗版一样;长期来看,其他实验室也会发布能力相当的模型。
- 全面禁止访问 Mythos 或 Astra:这会让情况雪上加霜——防御方在最需要工具的时候,失去最强大的武器。正确的做法是像前沿实验室已经在做的那样,限制仅允许经批准的机构和个人访问。除非有实验室违规,否则可能无需出台新政策。
- 禁止销售/出口新型 GPU 或大内存设备:能小幅延长一年左右的缓冲期,但长期无用。它无法解决现有硬件的问题,还会引发广泛不满。尤其是内存,几乎所有设备都需要,很难监管。
企业与技术层面建议
优先解决漏洞的分类处理和修复问题。发现漏洞的成本越来越低,而修复成本却居高不下。
- 利用涌入行业的数十亿美元资金,全面提升安全水平。尽可能多地招聘安全工程师,为现有维护人员提供资金支持。指导这些工程师和维护人员重点开展漏洞分类、修复方案设计、代码审查、补丁回溯和部署工作,而非主要负责发现漏洞或编写新代码。
- 善用 Astra、Mythos 等前沿模型,抢在攻击者之前发现风险。采用结构化提示词,比如谷歌的「不安全 Rust 代码审查」https://github.com/google/rust-skills/tree/main/unsafe_rust_review,这比笼统地让模型「仔细找漏洞」有效得多。
- 大语言模型擅长编写补丁,但单次提示的效果不佳https://1password.com/blog/why-ai-generated-patches-still-require-human-review。应提供结构化提示词,并让模型进行**多轮自我审查**https://codeberg.org/jyn514/paracress/src/branch/code-dump/.agents/skills/_implementation-closeout.md,直到模型自身判定补丁质量达标。尽可能让模型自行测试修复效果,而非主观判断补丁是否有效,之后再提交给人工审查。
- 对智能体进行沙箱隔离。此前 OpenAI 与 HuggingFace 发生的攻击事件,就源于前沿实验室的模型测试;若操作不当,你自己的大语言模型也很容易引发事故。限制凭证的权限范围:如果发证机构不支持权限范围限制,就在服务前端设置「可信接口」https://github.com/jyn514/dotfiles/tree/dev/tools/zulip-proxy来添加权限限制,切勿让智能体直接访问高权限凭证。**不要仅依赖过滤 GET 请求**https://unit42.paloaltonetworks.com/bypass-of-aws-sandbox-network-isolation-mode/,应在防火墙层面拦截请求,仅开放可信域名列表;通过网络代理和可信接口过滤端点,而非依赖智能体可篡改的本地配置;保留智能体发起的每一次修改或网络请求的日志。
- 投入资源开展形式化验证、模糊测试和属性测试,使用内存安全语言https://www.usenix.org/conference/enigma2021/presentation/gaynor。大语言模型擅长编写 Lean 代码https://arxiv.org/html/2606.05632v1和模糊测试用例https://danluu.com/ai-coding/#testing-background。新代码可以用 Go 或 Rust,但看在上帝的份上,**别用 C 或 C++**https://blog.google/security/rust-in-android-move-fast-fix-things/。
- 优化漏洞分类流程:记录受影响的系统版本,为高危漏洞指定负责人和修复期限,开发工具在漏洞修复后自动更新或关闭问题。
- 完善补丁回溯、发布和部署机制。测试升级和回滚等基础操作。如今开发工具成本低廉,可利用大语言模型减少人工在每个补丁上的耗时:比如依赖更新自动化、签名可复现的发布流程、提升部署速度。工程师应将时间用于协调漏洞披露和频繁发布,而非单个补丁的编写。
- 淘汰老旧且不安全的系统版本。如今形势已发生根本性变化:你急于推进升级,依赖这些系统的用户同样迫切。可借此推动他们升级。尽可能开发工具,帮助用户自动完成升级。跟踪用户的升级和补丁安装情况,若用户不愿升级,就加大工具开发投入。
- 未来会有大量补丁发布,且 embargo(漏洞披露 embargo,即漏洞修复前的保密期)结束后,漏洞会被迅速利用。统计从漏洞报告到补丁部署完成的全流程耗时,针对瓶颈开展优化。尽可能缩短 embargo 时长:既然你能发现漏洞,攻击者很可能也能,因此协调修复的窗口期比以往更短。
- 加强供应链安全管理:梳理软件和基础设施的依赖关系,盘点自身系统:生产环境运行的是哪个版本?哪些服务没有维护人员?哪些系统已停止支持(EOL)?现在你终于有能力全面审查所有依赖项,而非走马观花——优先审查高权限和安全敏感的依赖项。大语言模型在给定源代码的情况下,擅长发现漏洞,应充分利用这一点。
- 投入资源开展隔离和恢复演练。不要仅依赖单一防火墙或 VPN,应采用纵深防御策略:划分网络区域、限制凭证权限、测试备份、开展应急响应演练。尽可能练习从零启动系统。
- 密切关注前沿模型和开源权重模型的发展。模型越先进,留给我们打补丁和部署的时间就越少。
即便你不认为本文描述的威胁真实存在,这也是一次千载难逢的机会,能大幅提升你的项目和社区的安全水平。请务必抓住它。
我们正身处一个充满变数的时代,不能视而不见。趁还有时间,我们必须立即行动。
感谢 Manish Goregaokar 及其他人士对本文的反馈。感谢所有为 Glasswing 和 Daybreak 计划不懈努力的人。另外,想对 DeAlignAI、Z.ai 以及所有参与这场「逐底竞赛」的人说一句:去你的。
¹ 不同机构的数据存在差异,Z.ai 和 OpenAI 对具体分数的说法不一致。↩
欢迎参与讨论: Hacker News、 Lobste.rs、 Mastodon、 Bluesky