Desert Ant Labs:端侧小模型,快而免费
今日,我们正式推出欧洲前沿AI实验室Desert Ant Labs。我们秉持"设备优先"的理念,专注开发有明确功能取向的端侧智能,坚信高效智能的最优路径始于设备本地。
我们打造的是面向音频、视觉、文本领域的小型专用模型:每款模型响应速度达毫秒级,运行零成本,让智能能力渗透产品的每一次交互,彻底摆脱调用成本与推理速度的限制。这些模型体量小巧,五年前的旧款手机也能流畅运行;速度极快,可支持逐帧处理或随按键实时响应;性能更超越你正在付费使用的各类API。
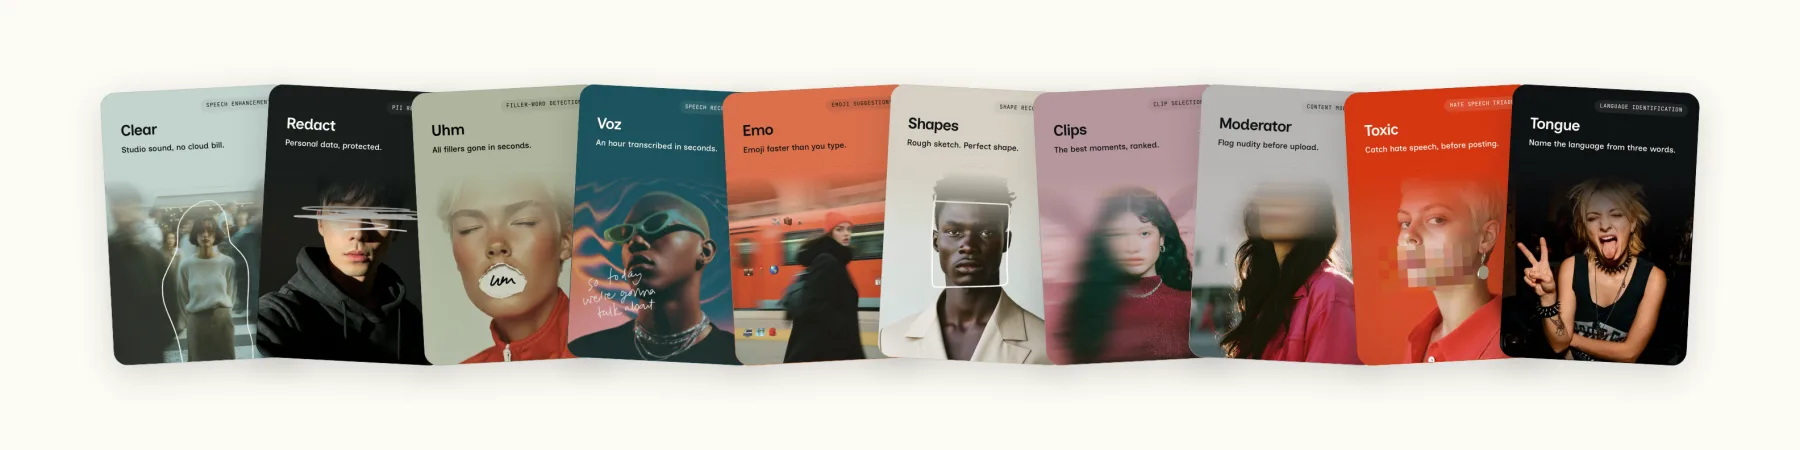
首批18款模型今日正式上线(12款稳定版,6款测试版),开发者可通过统一SDK接入,支持Swift、Kotlin、JavaScript三种开发语言。每个模型对应一项专属任务,专为在设备端最快完成该任务而设计:
- Voz:在iPhone上仅需2秒即可完成10分钟音频转写,速度是Whisper的4.7倍,还能精准标记每个词的起止时间。
- Clear:仅9MB的轻量模型,1秒就能把5分钟的笔记本录音优化至专业工作室音质。
- Redact:支持27种语言,可实时屏蔽姓名、地址、银行卡号等敏感信息,确保数据永远不会上传至你的服务器。
- Tongue:2MB的超轻量模型,仅凭3个单词即可识别84种语言。
以上只是部分代表,其余14款模型的完整规格与基准测试数据,可访问desertant.com/models及Hugging Face查看。所有模型每月支持最多10万台活跃设备免费使用,无需按调用量付费,也无需登录。
我们扎根欧洲开展研发,这里的监管环境天然倾向端侧智能:用户数据全程留存于本地设备,功能运行不依赖第三方云服务,从未上传的数据自然不存在被调取的风险。
我们的缘起
过去五年,我们开发视频应用Detail时,始终坚持"端侧优先"的原则。但当推出自动剪辑短视频、播客音频增强等功能时,我们不得不退而求其次,依赖云API实现。随着Detail的用户量增长,我们的基础设施账单也水涨船高。
每隔几个月,我就会四处寻找实用的端侧模型——比如在Hugging Face上搜索能识别冗余语气词或优化录音的模型。每年六月,行业都会推出新的开发工具,但整体进展依旧缓慢。其实基础条件早已成熟:适配的芯片、Core ML框架、前沿研究成果一应俱全。缺失的是从基础能力到落地功能的"最后一公里":一款能轻松嵌入应用、仅需几行代码即可上线的现成模型。
于是我们决定自己训练模型。事实证明,模型训练本质是产品设计问题,而这正是我们的专长。我们打造的模型与本地推理方案,在速度、质量、成本上全面超越云服务,在特定任务中的表现优于其他端侧或云端模型,体量却仅为它们的几分之一。
我们用Clear替代了Dolby,实现了更优质、更快速的音频增强;用Voz让端侧转写速度提升了5倍。我们还推出284MB的Clips模型,替代Claude Sonnet:它能在5秒内将10分钟视频剪辑为十几条短视频,速度是Sonnet的10倍,能耗仅为其1/470,剪辑质量却不相上下。
即将随iOS 27一同发布的Detail 6版本,将彻底弃用所有云API,全部功能由我们自研的端侧模型实现。
过去几年,我们都把大语言模型(LLM)当成普通API来用。在通用型大模型的 hype 热潮中,我们几乎忘了它们并非唯一选择。
我接触过的每位开发者都有一份"理想端侧模型清单":如果成本不成问题,他们早就开发这些模型了;或是有些功能一直在消耗大量调用费用,他们迫切希望用端侧模型替代。比如每天重复数十万次的标准化任务:优化录音、给照片打标签、从句子中提取日期、在文本上传前屏蔽姓名——这些任务完全不需要大模型。
NVIDIA的研究人员拆解了三套智能体系统后发现,40%至70%的大模型调用请求,其实都可以用小型专用模型替代。
算力已为你买单
今年全球数据中心的投入预计将达$4500亿。与此同时,全球每年出货超过10亿台手机、平板和笔记本电脑,这些设备搭载的芯片性能日益强劲,完全适配各类端侧AI任务。目前,用户手中的设备总算力,已经超过了全球所有AI数据中心的算力总和。
端侧推理拥有天然的成本优势:无需按调用次数付费,你可以让功能覆盖每一条消息,而非仅能负担得起的部分;无需往返传输数据,用户信息全程留在本地设备。当推理不再有成本顾虑,产品开发的思路将彻底改变。
每个产品都需要"小脑"
要让开发者愿意使用端侧模型,必须大幅优化开发体验:模型需支持商用,在特定任务的速度与质量上优于其他方案,仅需几行代码即可嵌入应用,且易于查找获取。
不妨把我们首批推出的百款模型比作小脑——负责维持平衡、把控节奏等无需刻意思考的基础功能,让大脑的其他部分能专注于更复杂的思考。我们率先打造的正是这类模型:快速、专用,全天候运行于设备端,且完全免费。
接下来我们将开发"大脑皮层"——一个负责调度决策的层:优先调用小型端侧模型,任务需要时再启用更大的模型,仅在必须脱离设备处理时才求助云端。随着开源研究的推进和设备芯片性能的提升,端侧模型的能力将不断增强,我们也会自主训练更大型的模型。我们的前沿智能体系,将从这些小型模型开始,逐步向上构建。
云端实验室倾向开发通用模型,因为按调用量付费的模式需要适配广泛场景。而Desert Ant的每款模型都带有我们预设的默认功能,同时提供灵活的自定义选项。我们将模型与运行时环境深度优化:在iPhone上,Clear和Voz会调用神经引擎(Neural Engine)运行;在浏览器中,Clear的相同权重可通过WebAssembly执行。
开发工具包(SDK)
准备好开始了吗?你可以通过我们的原生Swift、Kotlin、JavaScript SDK,将Desert Ant模型集成到你的应用中,SDK可在GitHub获取。
我们的文档专为开发者和代理商撰写,你可以通过命令行工具(CLI)在Mac上试用模型,也可在Hugging Face的网页端体验。
正在用我们的模型开发有趣的项目,或是想参与模型共建?欢迎联系我们。